최근에 AI의 한국어 성능을 비교하는 프로젝트를 진행했는데요, 신모델이 나와서 테스트를 진행해봤습니다.
테스트 방법
KoBALT-700은 700문항, 난이도 3단계(182/220/298), 5개 언어 영역, 10지선다로 이루어진 테스트 입니다.
한국어 대규모 언어 모델(LLM)을 평가하기 위한 언어학 기반 벤치마크로, 5개의 핵심 언어학 영역에 걸쳐 24개의 세분화된 언어학적 현상을 다루는700개의 전문가 작성 객관식 문제로 구성되어 있습니다.
결과
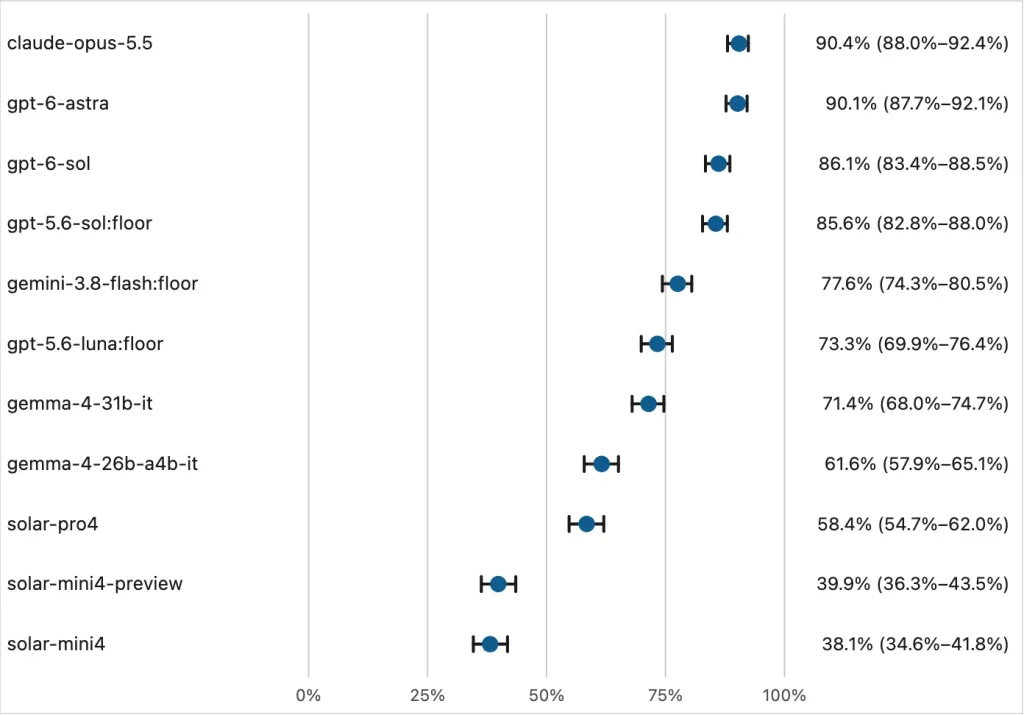
무려 아스트라를 넘어서 1위를 차지했네요! 세부 결과도 살펴봅시다.
| 난이도 | 오푸스 5.5 | 지피티 6 솔 |
| 1 | 181/182 | 180/182 |
| 2 | 209/220 | 207/220 |
| 3 | 243/298 | 216/298 |
오푸스 5.5와 지피티 6솔은 1단계 2단계는 거의 비슷했는데 3단계에서 갈렸네요.
추가로 오푸스 5.5가 생각을 더 많이 하고 토큰도 더 많이 소모했습니다.
5.6 솔 vs 6솔
| 난이도 | 5.6 솔 | 6 솔 |
| 1 | 177/182 | 180/182 |
| 2 | 208/220 | 207/220 |
| 3 | 214/298 | 216/298 |
5.6솔과 6솔은 거의 차이가 없었습니다. 테스트 가격이 절반으로 줄어 토큰 효율은 늘긴 했습니다.
그리고 1회 실행 결과라 근소한 차이는 실제 차이가 아닐 수 있습니다
마무리
벤치마크 출처
@misc{shin2025kobaltkoreanbenchmarkadvanced,
  title={KoBALT: Korean Benchmark For
         Advanced Linguistic Tasks},
  author={Hyopil Shin and Sangah Lee and
          Dongjun Jang and Wooseok Song and
          others},
  year={2025},
  eprint={2505.16125},
  archivePrefix={arXiv},
  url={https://arxiv.org/abs/2505.16125}
}