같은 700문항 한국어 벤치마크(KoBALT-700)에서 오푸스 5.5는 90.4%(633/700), 소넷 5.5는 81.3%(569/700) 를 기록했습니다. 차이는 9.1%포인트, 64문항입니다. 한국어 정확도가 중요한 작업이라면 오푸스 5.5가 확실히 앞서고, 소넷 5.5도 700문항 중 569문항을 맞히는 수준입니다.
들어가며 — “소넷이랑 오푸스, 뭐가 다르냐”에 숫자로 답하기
클로드 소넷(Sonnet)과 오푸스(Opus) 중 무엇을 골라야 하는지는 자주 나오는 질문입니다. 보통은 “오푸스가 더 똑똑하고, 소넷이 더 빠르다” 정도로 정리되지만, 한국어에서는 실제로 얼마나 차이가 나는지는 잘 알려져 있지 않습니다.
그래서 두 모델을 같은 조건에서 직접 측정했습니다. 마케팅 문구가 아니라, 한국어 언어 능력을 겨루는 공개 벤치마크의 같은 문제·같은 프롬프트로 돌린 결과입니다.
어떻게 측정했나
KoBALT-700은 서울대 언어학과 CL_NLP 연구실과 LG AI Research가 만든 한국어 언어 능력 벤치마크로, 전문가가 작성한 700문항을 다섯 영역에서 평가합니다.
| 영역 | 내용 |
|---|---|
| 의미론 (Semantics) | 단어·문장의 의미 관계 |
| 통사론 (Syntax) | 문장 구조와 문법성 |
| 화용론 (Pragmatics) | 함축, 의도, 맥락 해석 |
| 음성·음운 (Phonetics/Phonology) | 발음과 음운 규칙 |
| 형태론 (Morphology) | 조사·어미 등 단어 형태 |
측정 조건은 두 모델이 동일합니다.
- 한국어 추론(CoT) 프롬프트, greedy 디코딩(무작위성 없음), 최대 2,048토큰
- 정답 추출 방식까지 동일
- 측정일: 오푸스 5.5 — 2026년 9월 22일 / 소넷 5.5 — 2026년 9월 28일
전체 결과
| 모델 | 정답 | 정확도 |
|---|---|---|
| 클로드 오푸스 5.5 | 633/700 | 90.4% |
| 클로드 소넷 5.5 | 569/700 | 81.3% |
차이는 9.1%포인트(64문항) 입니다. 한 문항 한 문항이 실제 한국어 문법·의미 판단 문제라는 점을 감안하면 작지 않은 차이입니다.
영역별로 보면 더 분명해집니다
| 영역 | 오푸스 5.5 | 소넷 5.5 | 차이 |
|---|---|---|---|
| 의미론 | 85.6% | 79.1% | +6.5%p |
| 통사론 | 91.3% | 81.3% | +10.0%p |
| 화용론 | 93.8% | 80.2% | +13.6%p |
| 음성·음운 | 93.5% | 88.7% | +4.8%p |
| 형태론 | 97.6% | 83.3% | +14.3%p |
읽을 점 세 가지:
- 두 모델 모두 ‘의미론’이 상대적으로 약했습니다. 오푸스 5.5의 최저 영역도 의미론(85.6%)이고, 소넷 5.5도 마찬가지(79.1%)입니다.
- 격차가 가장 큰 곳은 형태론(+14.3%p)과 화용론(+13.6%p)입니다. 조사·어미 같은 문법 형태 처리와, 말의 의도·함축을 읽는 문제에서 차이가 벌어졌습니다.
- 차이가 가장 작은 곳은 음성·음운(+4.8%p)입니다. 표기 규칙 중심의 문제라 상대적으로 두 모델 모두 안정적이었습니다.
리더보드에서의 위치
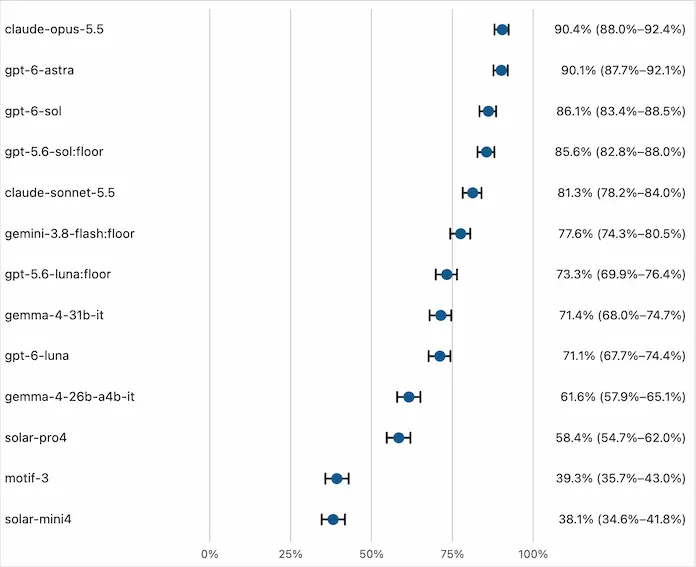
이 기록에 지금까지 올라온 모델들과 비교하면:
- 오푸스 5.5 — 90.4%, 전체 1위. 2위 GPT-6 아스트라(90.1%)와는 0.3%p 차이로 사실상 동급입니다.
- 소넷 5.5 — 81.3%, 기본 설정 기준 4위. 3위 GPT-6 솔(86.1%)보다는 낮지만, 여러 최신 모델보다는 높습니다.
즉 한국어만 놓고 보면 오푸스 5.5가 현재 이 벤치마크의 최상위권이고, 소넷 5.5는 “중상위” 정도의 위치입니다. 전체 순위와 영역별 표는 기록 페이지에서 볼 수 있습니다.
그래서 뭘 쓰면 되나
| 이런 작업이라면 | 추천 |
|---|---|
| 한국어 뉘앙스 판단, 문법 검수, 긴 문서 작성, 복잡한 추론 | 오푸스 5.5 — 정확도가 우선일 때 |
| 요약, 초안 작성, 일상 대화, 반복 작업 | 소넷 5.5 — 속도와 비용이 우선일 때 |
소넷 5.5의 81.3%는 낮은 점수가 아닙니다. 700문항 중 569문항을 맞히는 수준이고, 단순 요약·번역 같은 작업에서는 체감 차이가 크지 않을 수 있습니다. 다만 조사·어미, 함축 해석처럼 한국어다운 부분에서 정확도가 중요한 작업이라면 두 모델의 9%포인트 차이는 기억해 둘 만합니다.
API 가격 기준 소넷 5.5는 1M 토큰당 $2 / $10, 오푸스 5.5는 $4 / $20입니다.
소넷 5.5 측정 부터는 벤치마크 결과에 가격도 포함 시켰는데 $7.68가 소모됐습니다. 오푸스 5.5는 약 2배정도 들었는데 정확한 수치는 아닙니다.
벤치마크 웹사이트
다른 모델들의 측정 결과가 궁금하시면 웹사이트에서 더 많는 정보를 확인하실 수 있습니다.
한계와 주의
- 구성당 1회 측정입니다. 구간(신뢰범위)은 700문항 내 표본 불확실성을 나타내며, 실행 간 반복 측정값은 아닙니다.
- 수치는 2026년 9월 기준입니다. 모델이 업데이트되면 결과가 달라질 수 있습니다.
- 벤치마크 점수는 실제 작업 체감과 완전히 일치하지 않습니다. 참고 지표로 보세요.
자료
- KoBALT-700 데이터셋: https://huggingface.co/datasets/snunlp/KoBALT-700
- 데이터셋 저장소: https://github.com/snunlp/KoBALT-700
- 논문: https://arxiv.org/abs/2505.16125